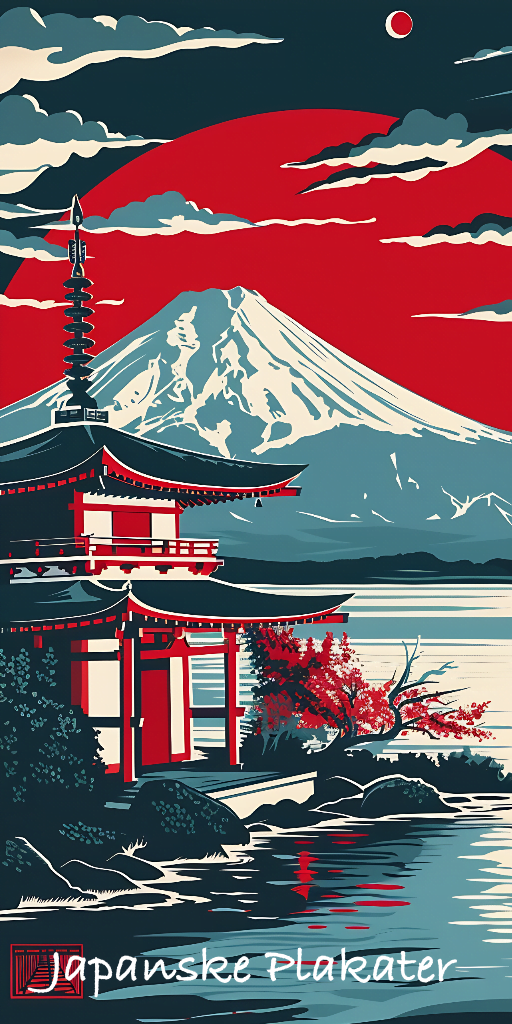

De japanske kreative giganter har fået nok. Studio Ghibli, Bandai Namco og Square Enix har sammen med andre tungvægtere krævet, at OpenAI stopper med at fodre deres AI-monster Sora 2 med japansk indhold – og det er ikke en høflig anmodning.
Når AI bliver for glad for anime
Det hele startede, da OpenAI lancerede Sora 2 den 30. september og pludselig regnede det ned med AI-genereret indhold, der lignede japanske tegnefilm og spil mistænkeligt meget. Så meget, at selv den japanske regering måtte blande sig og formelt bede OpenAI om at holde fingrene fra deres “uerstattelige skatte”.
Ironisk nok bruger OpenAI’s CEO Sam Altman selv et profilbillede på X, der minder påfaldende meget om Studio Ghibli-stil. Man kunne kalde det en anelse hyklerisk.
CODA slår hårdt ned
Content Overseas Distribution Association (CODA), der repræsenterer de japanske IP-indehavere, har sendt et skarpt brev til OpenAI. Deres budskab er krystalklart: “Stop med at bruge vores indhold uden tilladelse”.
CODA argumenterer for, at selve kopieringsprocessen under maskinlæring kan udgøre krænkelse af ophavsretten – især når AI’en efterfølgende spytter indhold ud med copyrightbeskyttede karakterer.
Opt-out? Nej tak!
OpenAI forsøgte at redde situationen ved at tilbyde en opt-out-politik for IP-indehavere. Men ifølge japansk lov holder det ikke. Som CODA pointerer: “Under Japans copyright-system kræves der generelt forudgående tilladelse” – man kan ikke bare bruge først og spørge om tilladelse senere.

Det er lidt som at låne naboens bil og så sige: “Du kan jo bare sige til, hvis du ikke vil have det.”
Regeringen blander sig
Den japanske regering har også taget handsken op. Digital Minister Masaaki Taira har advaret om, at hvis OpenAI ikke samarbejder frivilligt, kan regeringen aktivere bestemmelser under AI Promotion Act.
Når selv politikerne begynder at tale om anime som “uerstattelige skatte”, ved man, at det er alvor.
Ikke første gang
Dette er faktisk ikke OpenAI’s første dans med japansk IP. Allerede ved lanceringen af GPT-4o i marts så vi en eksplosion af “Ghibli-stil” billeder. Det ligner et mønster, hvor OpenAI systematisk har trænet på japansk kreativt indhold.
Hvad nu?
CODA kræver nu, at OpenAI “reagerer oprigtigt” på deres copyright-krav og stopper med at bruge japansk IP som træningsdata. Det inkluderer ikke bare Sora’s output, men hele træningsprocessen.
OpenAI har endnu ikke reageret på de seneste krav, men sagen repræsenterer en betydelig eskalering i den globale debat om AI-træningsdata og ophavsret. Spørgsmålet er, om tech-giganten vil lytte – eller om vi får en rigtig copyright-krig mellem Silicon Valley og Japan.