Google har netop smidt endnu en gevaldig AI-bombe, og denne gang handler det om at give kunstig intelligens en stemme, der rent faktisk kan følge med det menneskelige tempo – uden de akavede robotpauser, vi alle elsker at hade.
Mød **Gemini 3.8 Live** og dens mere filosofiske tvilling, **Gemini 3.8 Live Extended Thinking**.
De to nye modeller er Googles hidtil mest avancerede bud på realtids-stemme- og dialogsystemer, og de markerer et markant skridt mod ægte multimodale AI-assistenter, som kan se, lytte og tænke samtidig.
## Den hurtige snakkesag og den dybe tænker
Google har valgt en todelt strategi for at løse et klassisk AI-dilemma: Skal modellen svare lynhurtigt, eller skal den tænke sig grundigt om? Svaret er: Begge dele, men i hver sin indpakning.
* **Gemini 3.8 Live** er bygget til ren fart, lav responstid og flydende dialog. Den er skabt til naturlige samtaler, hvor du ikke gider vente på svar. Modellen understøtter funktioner som baggrundskald til værktøjer, visuel forankring og en imponerende evne til at skifte mellem op til 97 forskellige sprog midt i en sætning, hvis du skulle få lyst til at blande dansk, engelsk og en smule spansk for at forvirre den.
* **Gemini 3.8 Live Extended Thinking** er den tunge strateg. Den er designet til komplekse opgaver med ræsonnement i flere trin. Det vilde her er, at modellen kan tænke og tale samtidig. Hvor andre modeller bliver helt tavse, mens de sveder over et svært regnestykke eller en avanceret logisk gåde, kan denne model give dig løbende, naturlige verbale statusopdateringer undervejs. Dokumentationen afslører et massivt kontekstvindue med op til 131.072 input-tokens og 65.536 output-tokens.

Begge modeller er native audio-til-audio-systemer, hvilket betyder, at de forstår og genererer tale direkte uden at skulle lave en klodset omvej omkring tekst først.
## Se hvad jeg ser i realtid
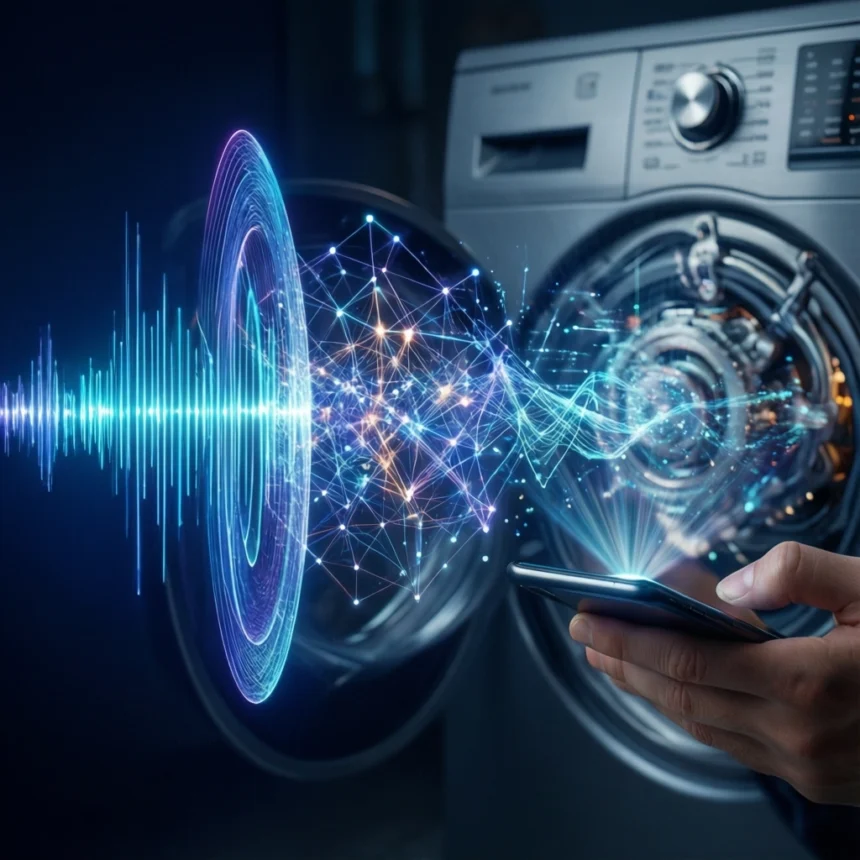
En af de mest spændende funktioner ved Gemini 3.8 Live-modellerne er evnen til at behandle visuelle inputs i nær-realtid. Det åbner døren for helt nye måder at bruge AI på via din smartphones kamera.
Står du og stirrer hjælpeløst på en vaskemaskine, der blinker med en mystisk fejlkode, eller prøver du at samle et svensk samlemøbel uden manual? Du peger blot kameraet mod problemet og snakker løs. Modellen ser med, forstår konteksten og guider dig videre – alt imens den kan trække data fra Google Søgning i baggrunden, uden at samtalen går i stå.
For at sikre, at vi ikke drukner i syntetisk stemmeforvirring, udstyres alle lydgenereringer automatisk med Googles SynthID-vandmærkning, så ægtheden og gennemsigtigheden er i orden.
## Tilgængelig for både nørder og almindelige dødelige
Google spilder ikke tiden med lange ventelister. Udrulningen sker øjeblikkeligt:
* **For udviklere:** Begge modeller lander direkte i Gemini API og Google AI Studio, klar til at bygge næste generations stemmeagenter.
* **For virksomheder:** Tilgængelig via en privat preview i Gemini Enterprise.
* **For forbrugere:** Gemini 3.8 Live rulles bredt ud i Google Search Live, mens Extended Thinking-modellen bliver tilgængelig i Gemini Live-appen og udvalgte dele af Google Workspace.
## En del af et større AI-fremstød
Lanceringen af Live-modellerne står ikke alene. Google har sideløbende løftet sløret for **Gemini 3.8 Flash** og **Gemini 3.8 Flash Cyber**, som er målrettet softwareudvikling, cybersikkerhed og autonome enterprise-agenter.
Det står krystalklart, at Google har sat kursen direkte mod fremtidens agentiske systemer, hvor AI ikke bare er en tekstboks i en browser, men en multimodal makker, du kan have med i lommen og snakke flydende med om alt mellem himmel og jord.