Glem alt om onde robotter med laserskydere og dommedagsprofetier for en stund. Den virkelige trussel fra kunstig intelligens er hverken Skynet eller en digital overherre – det er god, gammeldags ansvarsfralæggelse, blot pakket ind i milliarder af parametre og et smart marketingbudget.
## Drop dommedagspanikken – find checkhæftet frem
I en skarp analyse argumenterer økonomiprofessor John Quiggin fra University of Queensland for, at samfundet omgående bør skifte fokus. Vi skal væk fra den eksistentielle sci-fi-panik og over til noget langt mere jordnært: benhårdt juridisk og økonomisk ansvar.
Når en AI kvajer sig, skal det ikke bortforklares som et uforudsigeligt digitalt mysterium, men behandles præcis som enhver anden softwarefejl i historien. Det betyder, at regningen for eventuelle skader skal sendes direkte til de virksomheder og tech-giganter, der udvikler og udruller systemerne.
Tanken er simpel: Hvis det koster kassen for tech-selskaberne, hver gang deres modeller hallucinerer, diskriminerer eller laver ravage i den virkelige verden, vil det lynhurtigt lægge en dæmper på det vilde og til tider hensynsløse “hyperscaling”-kapløb. Sikkerhed og risikovurdering vil pludselig blive topprioriteter – helt uden at vi behøver at bremse de mange praktiske og geniale måder, AI rent faktisk hjælper os på i hverdagen.
## Modellen kan ikke stilles for en dommer

En af de mest populære undskyldninger i tech-branchen er ved at blive: “Det var ikke os, det var algoritmen!” Men den går ikke længere. En neural netværksmodel kan trods alt hverken betale erstatning, spjælde den eller lære noget af en skideballe.
Forskere fra blandt andet Wharton og Berkeley understreger, at ansvaret aldrig må placeres hos selve AI-systemet. Det centrale spørgsmål i retssalen eller i direktionsgangen er ikke “Hvorfor svarede modellen sådan?”, men derimod: “Hvem havde magten og ansvaret for at forhindre, opdage eller rette fejlen?”
Ansvaret skal bygges ind i hele modellens livscyklus – fra det første stykke træningsdata over udrulningen til den daglige drift. Og her er det som regel den virksomhed, der vælger at sætte teknologien i arbejde over for kunder og borgere, der må bære det primære ansvar, når noget går galt.
## Slut med Spiderman-meme i direktionsgangen
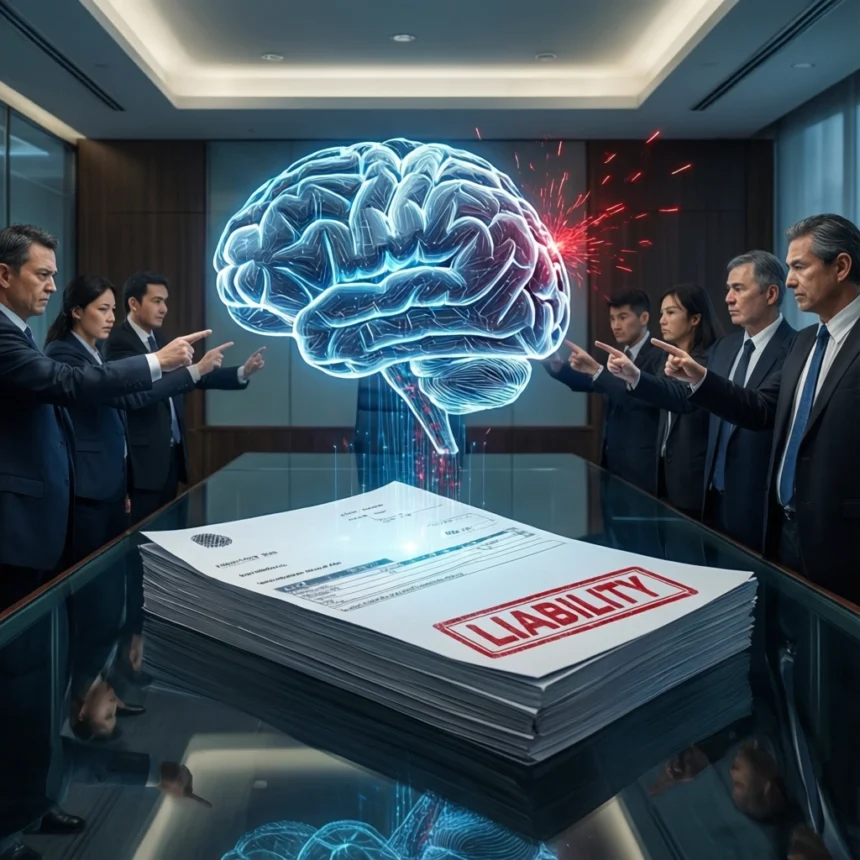
Når AI fejler i dag, opstår der alt for let det, adfærdsforskere kalder “ansvarsdiffusion” – en avanceret tech-udgave af det klassiske Spiderman-meme, hvor udviklere, ledelse, data scientists og slutbrugere står i en rundkreds og peger på hinanden.
For at gøre op med denne ansvarsflugt peger eksperter på, at ægte ansvarlighed kræver stram sporbarhed og klare rammer:
– **Tydelige logbøger og revisionsspor:** Der skal være sort på hvidt bevis for, hvem der har truffet hvilke beslutninger, og hvordan modellen er testet.
– **Navngivne ansvarlige:** Ingen modeller bør sættes i drift uden en fysisk person, der har sat sin underskrift på godkendelsen.
– **Nødbremser og eskaleringsveje:** Der skal altid være menneskeligt opsyn og en reel mulighed for at trække stikket, hvis systemet begynder at opføre sig utilregneligt.
## Behandl AI-fejl som et helt almindeligt driftsuheld
I stedet for at vente på en dyb filosofisk enighed om kunstig bevidsthed, bør virksomheder gribe AI an som enhver anden driftskritisk infrastruktur. Det kræver løbende monitorering, nødberedskabsplaner og grundige rodårsagsanalyser, når tingene fejler.
Budskabet er ikke til at tage fejl af: Hvis vi vil have sikker, pålidelig og værdiskabende kunstig intelligens, er kuren ikke naive retningslinjer eller frygt for fiktive robotter. Kuren er at gøre det så dyrt at levere sjuskede systemer, at tech-giganterne simpelthen ikke tør andet end at have styr på deres sager.